
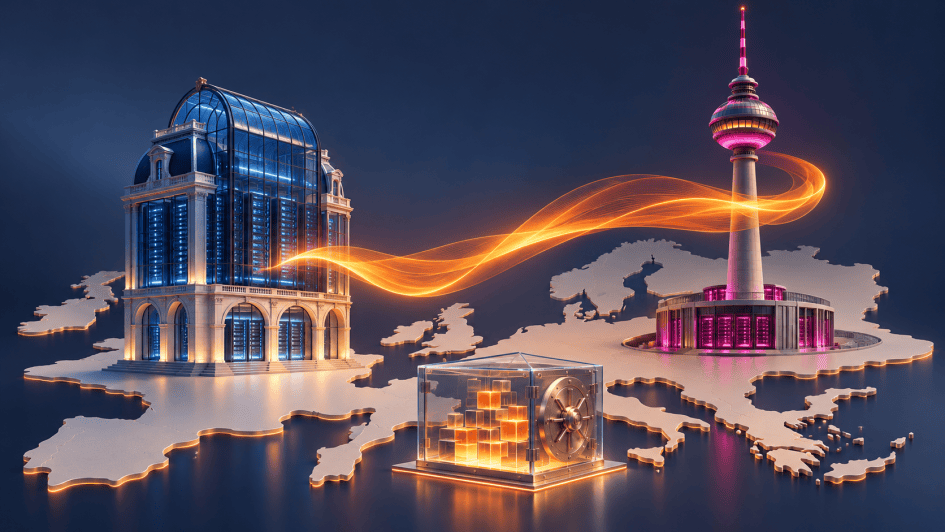
Cent millions d’euros : le chiffre est facile à retenir. Le changement qu’il annonce l’est moins. Le 19 novembre 2026, Deutsche Telekom a annoncé un investissement de son fonds T.Capital Tech Fund dans Mistral AI, avec l’objectif de préparer une coopération autour de l’intelligence artificielle pour les entreprises et les institutions allemandes.
Pour comprendre l’intérêt de l’opération, il faut sortir du simple classement des levées de fonds. Une IA d’entreprise ne se résume pas à un modèle capable de rédiger. Il faut aussi savoir où elle fonctionne, qui l’exploite et comment elle accède aux documents. C’est sur ces questions que l’annonce mérite d’être suivie.
Ce qui est annoncé : un investissement, puis un partenariat à construire
Le communiqué de Deutsche Telekom situe les 100 millions d’euros dans la série D de Mistral. Il présente l’opération comme une première étape vers un futur partenariat stratégique associant infrastructure, intégration et relations clients de Telekom aux modèles et logiciels d’entreprise de Mistral.
Les entreprises et institutions publiques allemandes, notamment les activités industrielles et les secteurs réglementés, constituent le public visé. Le texte ne décrit pas une acquisition de Mistral et ne donne pas de pourcentage de capital acquis. Il ne suffit pas non plus à établir qu’une offre commune est déjà disponible à la commande.
Cette différence de statut est essentielle. Un financement crée des moyens et rapproche des partenaires. Une offre exploitable demande encore un périmètre, des modalités techniques, un contrat et un accompagnement. L’annonce donne une direction ; les détails du service permettront d’en mesurer la portée.
Pourquoi l’Allemagne apparaît au centre du projet
Le rapprochement s’inscrit dans une présence déjà renforcée de Mistral dans le pays. Le 28 septembre, Mistral annonçait son implantation à Munich, avec des équipes consacrées à l’IA industrielle et à la physique, ainsi que des ingénieurs appliqués aux projets de ses partenaires.
L’entreprise y évoquait notamment des travaux avec BMW sur la simulation de collisions et avec Siemens Energy sur des usages industriels. Ce contexte est plus précis que l’idée d’un assistant de conversation supplémentaire : les problèmes abordés peuvent concerner des processus, des calculs et des connaissances propres à une organisation.
Notre lecture de l’accord est donc celle d’un rapprochement entre une technologie et les moyens de la déployer auprès de clients existants. Cette interprétation ne préjuge ni de la réussite commerciale du projet ni des résultats d’un futur produit. Elle explique simplement pourquoi un opérateur et un laboratoire d’IA peuvent avoir intérêt à travailler ensemble.
Modèle, hébergement, accès : trois couches qu’il ne faut pas confondre
Le modèle produit ou transforme des réponses à partir de ce qu’on lui transmet. Le choisir, c’est notamment décider quelles capacités on veut utiliser et sous quelles conditions. Son origine ne décrit pas à elle seule toute la chaîne de traitement.
L’hébergement désigne l’environnement dans lequel ce traitement s’exécute. Une organisation peut vouloir un service géré ou un déploiement qu’elle exploite davantage elle-même. Chaque formule déplace des responsabilités : maintenir les composants, surveiller les accès, assurer la disponibilité et organiser les mises à jour.
Les droits d’accès déterminent les documents qu’un utilisateur peut réellement mobiliser. Même dans un environnement bien choisi, un assistant qui retrouve les mauvais dossiers peut créer un problème. Le contrôle doit donc porter aussi sur les sources, les connecteurs et les autorisations, pas seulement sur le nom du modèle.

« En Europe » : une information utile, mais pas une réponse complète
Dans son annonce du 11 août sur l’inférence régionale, Mistral présente le choix d’une région d’exécution Europe ou États-Unis. L’entreprise mentionne aussi des transferts limités et encadrés vers des sous-traitants, décrits dans son Trust Center. Cette précision illustre pourquoi il faut lire le périmètre exact d’une promesse de localisation.
La résidence d’un traitement, les intervenants autorisés et la durée de conservation sont des questions différentes. Un logo européen n’y répond pas automatiquement. Inversement, une annonce commerciale incomplète ne démontre pas à elle seule qu’une configuration serait inadaptée : elle indique surtout ce qu’il reste à examiner.
Pour une équipe qui évalue un service, demander un schéma des flux peut être plus utile que demander si le produit est « souverain ». Où entre la requête ? Quel composant lit les fichiers ? Où sont les journaux ? Qui peut les consulter ? Une réponse concrète rend les choix discutables et vérifiables.
Exemple : un assistant qui cherche dans les documents d’une PME
Imaginons une entreprise qui veut retrouver rapidement ses procédures internes. Ce cas est hypothétique et ne décrit pas un client du partenariat. L’objectif pourrait être de poser une question et d’obtenir une réponse accompagnée des documents qui l’étayent.
Le premier travail n’est pas de connecter tous les dossiers disponibles. Il consiste à définir un ensemble de documents à jour et les personnes autorisées à les lire. Sans cette préparation, un système performant peut retrouver très vite une ancienne procédure ou montrer une information au mauvais service.
Le test devrait ensuite inclure des questions difficiles : une procédure supprimée reste-t-elle citée ? Un salarié voit-il un dossier réservé à une autre équipe ? Une réponse reconnaît-elle qu’elle manque d’information ? La qualité se juge sur ces situations autant que sur une démonstration fluide.
Enfin, l’entreprise doit pouvoir arrêter ou modifier le projet. Conserver les sources, comprendre les formats d’export et documenter les paramètres utilisés aide à préparer cette réversibilité. Le choix d’un prestataire gagne à inclure la sortie du service dès le départ.
Ce qu’il faudra regarder dans la future offre commune
- Le périmètre : assistant, accès à des modèles, traitement documentaire ou autre service clairement défini.
- L’exploitation : responsabilités respectives du client, de l’intégrateur et de l’hébergeur.
- Les données : flux, conservation, accès de support et sous-traitants documentés.
- Les preuves : essais sur les tâches réelles, avec erreurs et limites consignées.
- La continuité : mises à jour, disponibilité, export et conditions de changement de solution.
Cette grille ne constitue pas une certification ni un avis juridique. C’est une manière de comparer les réponses à un besoin avant de s’engager. Une promesse commerciale devient plus utile lorsqu’elle précise ce qu’elle couvre et ce qu’elle laisse au client.
Les utilisateurs particuliers vont-ils voir un changement ?
L’annonce du 19 novembre ne suffit pas à conclure qu’un compte personnel change d’hébergement, de prix ou de règles de confidentialité. Elle porte sur un investissement et une coopération d’entreprise envisagée. Pour un service que vous utilisez déjà, les références restent son annonce produit et ses conditions applicables.
Il serait donc prématuré de conseiller une migration individuelle sur cette seule nouvelle. En revanche, elle mérite l’attention de celles et ceux qui suivent l’IA européenne au-delà des classements de modèles : la capacité à installer et exploiter les outils dans de vraies organisations devient un enjeu visible.
Le prochain signal intéressant ne sera pas seulement un nouveau montant. Ce sera une offre détaillée, des modalités de déploiement et des résultats de terrain. Les 100 millions attirent le regard ; la manière dont l’IA utilisera les données donnera sa substance au projet.
Une lecture à partager avec votre communauté ?
Pour prolonger la lecture
 Récupérer des données après une panne : les bons premiers gestesDécouvrir l’article
 Protection des données personnelles : quelle autorité contacter ?Découvrir l’article
 Ajouter Midjourney sur Discord : bot, droits et confidentialitéDécouvrir l’article
 Ridisi : outils de lecture, pictogrammes et usages en classeDécouvrir l’article